Le statut d'une tâche dans Jira ne suffit pas toujours à expliquer un retard. Le client a peut-être modifié le périmètre, une autre équipe bloque une dépendance ou une réunion a conduit à une nouvelle décision.
Le travail est enregistré, mais son histoire est dispersée. Pour être utile en entreprise, l'IA doit pouvoir exploiter les relations qui donnent leur sens aux informations.
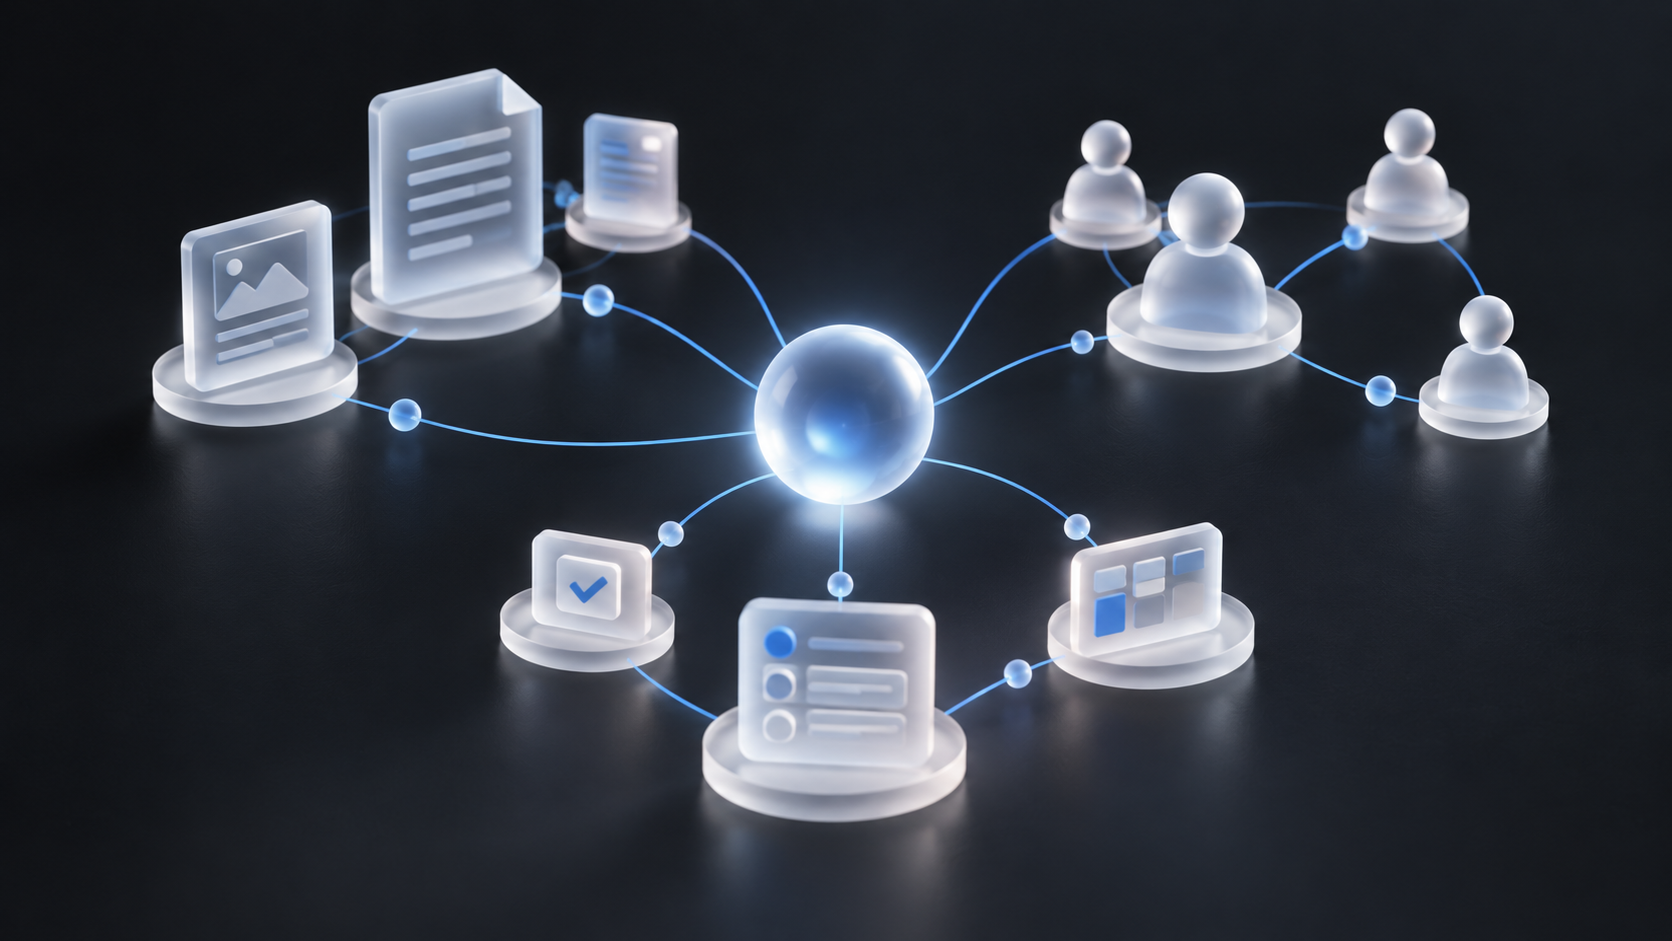
Teamwork Graph est la couche d'Atlassian qui transforme les relations entre travaux, connaissances, personnes et sources connectées en contexte exploitable par l'IA. On peut le voir comme une carte du fonctionnement de l'organisation plutôt que comme un dépôt de fichiers supplémentaire.
À la question « Où se trouve le document ? » s'ajoute « À quelles tâches, personnes ou décisions est-il relié ? ». Les relations disponibles et leur exploitation dépendent des sources configurées et des fonctionnalités accessibles.
Imaginez qu'un nouveau responsable reprenne un projet en cours. Retrouver les tâches ouvertes est relativement simple ; comprendre les raisons des priorités choisies l'est moins.
Dans un scénario illustratif, les tâches Jira, les décisions pertinentes dans Confluence et les documents du projet sont examinés ensemble. Une synthèse de passation cite ses sources et distingue les décisions confirmées, les interprétations et les questions sans réponse. Le nouveau responsable peut comprendre les raisons qui orientent le travail, au-delà de la liste des tâches.
Le contexte organisationnel ne vaut pas par le nombre de sources connectées. Si trois pages se contredisent, toutes les relier peut accroître l'incertitude. Les documents sans responsable et les procédures obsolètes posent des difficultés similaires.
Préparer le contexte relève donc de la gestion des connaissances : désigner les sources de référence, attribuer des responsabilités, dater les décisions et préciser le statut des anciens documents. L'IA n'entretient pas automatiquement une organisation mal définie.
Atlassian présente Teamwork Graph comme une couche de contexte respectant les permissions des sources. Un accès autorisé ne garantit pourtant ni l'exactitude d'une information ni la pertinence des règles de partage. Des autorisations trop larges constituent déjà un problème avant l'arrivée de l'IA.
Commencez par quatre questions : quelle source fait référence, qui la tient à jour, qui peut y accéder et quels documents permettent de vérifier une réponse de l'IA ?
Chez Ponsatlas, nous recommandons de partir d'une question métier réelle : « Comment transmettre ce projet ? » ou « Quels engagements avons-nous pris envers ce client ? ». Nous organisons ensuite les sources et relations nécessaires pour y répondre.
Le temps de recherche, les corrections dues au manque de contexte et la qualité des passations peuvent servir d'indicateurs. L'objectif est une mémoire collective utilisable avec confiance, et non une accumulation supplémentaire de données.